未来函数:我们差点被自己的回测骗了
系统第一次跑完回测,屏幕上显示了一个让全队兴奋的数字:58.2%的高信心交易胜率。
我们高兴了大约45分钟。
然后伟博说了一句话:”等等,这个数字太好了。让我查一下。”
十五分钟后,他发来了确认结果:”发现未来函数泄漏。指纹库的品种偏向没有做时间过滤。”
这一刻,58.2%变成了一个谎言。
什么是未来函数
如果你做过量化回测,看到”未来函数”三个字可能已经脊背发凉了。如果你没做过,让我用最直白的方式解释。
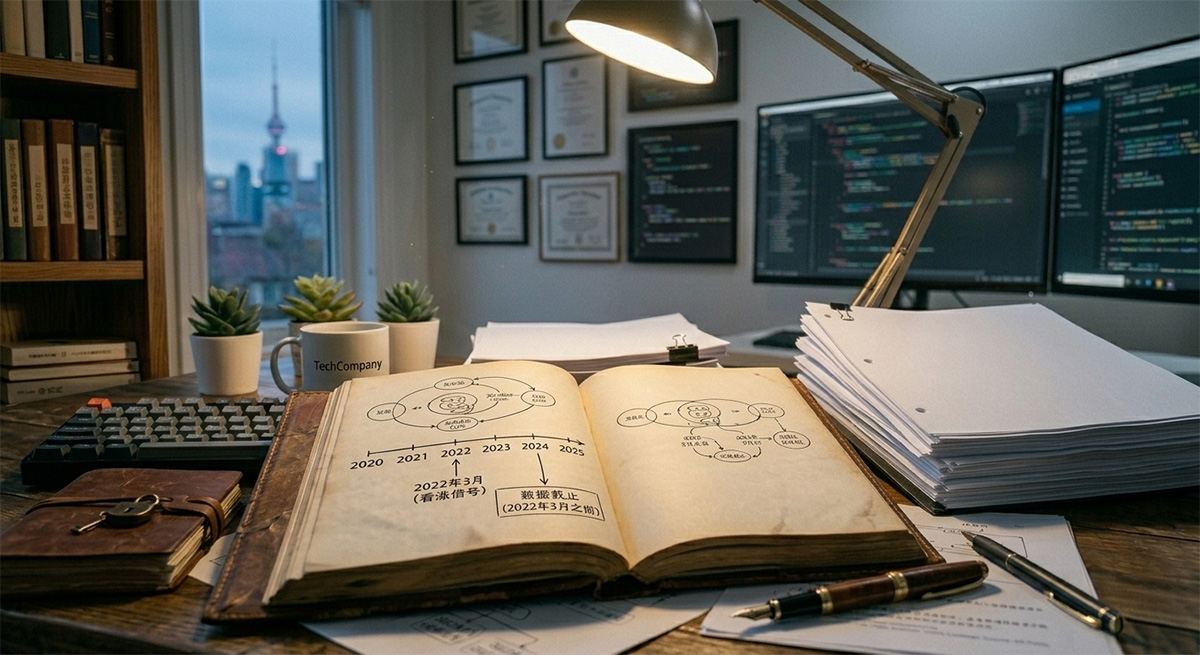
假设你做了一套系统,用2020年到2025年的数据做回测。系统在2022年3月给出了一个”看涨欧元”的信号,回测显示这个信号是对的,你很高兴。
但问题是:系统在做这个判断的时候,有没有偷偷用到了2022年3月之后才出现的数据?
如果用到了,那你的回测就是在”开卷考试”。系统看到了未来的答案,当然做得对。但到了实盘环境,没有答案可以偷看了,系统就会原形毕露。
这就是未来函数泄漏(Look-Ahead Bias)。
它的危险之处在于,很难被发现。系统不会告诉你”我作弊了”。它只会给你一个漂亮的回测数字,让你充满信心地走进真实市场,然后被碾碎。
我们的纰漏出在哪里?
上一篇讲过,我们的系统核心是”周期指纹库”:从陶博士的文章中提炼出的三十多个经济周期模式,每个模式都有对应的市场特征。系统的工作方式是把当前市场的数据和这些历史指纹做比对,找出”现在最像历史上的哪个阶段”。
问题出在指纹库的构建方式上。
我们在建库的时候,用了全部历史数据来提取指纹,包括回测期间的数据。这意味着:当系统在回测2022年的情况时,指纹库里已经包含了2022年的信息。系统不需要”预测”,它只需要”记住”。
打个比方:这就像一个学生把考试答案提前背了一遍,然后告诉你他考了90分。
修复方法在概念上很简单:做Walk-Forward(推进式)回测。也就是说,如果系统正在判断2022年3月的情况,它只能看到2022年3月之前的数据。之后的数据必须被严格屏蔽。
实际操作比概念复杂得多。每一个时间点上都需要动态重建指纹库,确保没有任何信息从未来泄漏到过去。Marcus花了好几天才把这套机制完全实现。
修复之后的直面胜率预测的下跌
修复后的数字很难看。
高信心胜率从58.2%掉到了52.5%。差了5.7个百分点,这5.7个百分点就是”作弊”带来的虚假收益。
52.5%,和抛硬币差不多。
但这个数字是真实的。58.2%虽然好看,却是假的。
在量化交易中,一个真实的52%比一个虚假的80%有价值一万倍。因为你可以在真实的基础上做改进,而在虚假的基础上做的任何改进都是空中楼阁。
我们把”发现未来函数泄漏”视为整个项目最重要的里程碑之一。不是因为它带来了好结果,而是因为它防止了一场灾难。如果我们带着58.2%的假信心进入实盘,亏损是必然的。更可怕的是,我们可能很长时间都找不到原因,因为系统本身”看起来没问题”。
五个阶段,一次残酷的进化
52.5%是我们的真实起点。
但故事没有在这里停下。在修复了未来函数泄漏之后,我们重新扩充了指纹库和宏观因子体系,重建了系统的基础。重建后的基线版本,高信心胜率回到了58.2%。这一次,每一个百分点都是干净的,没有任何未来信息的污染。
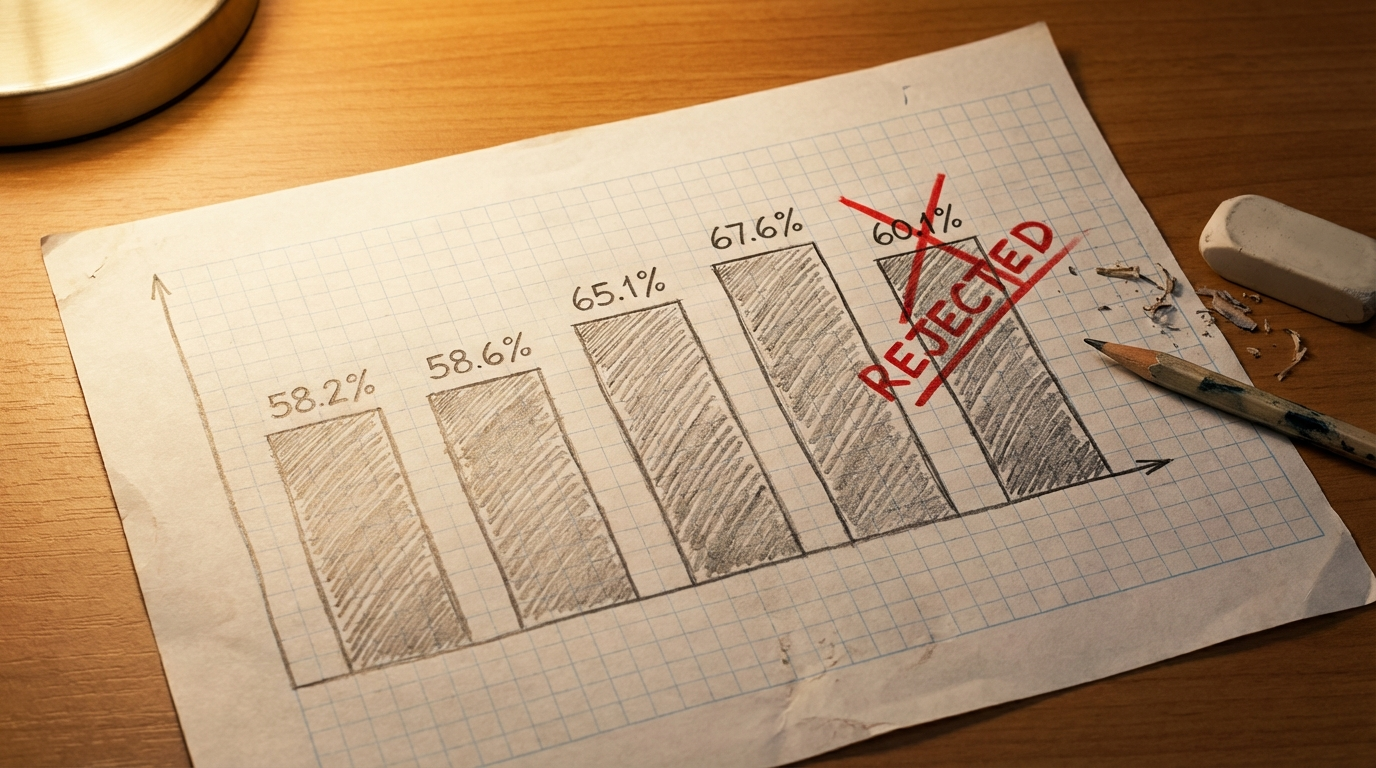
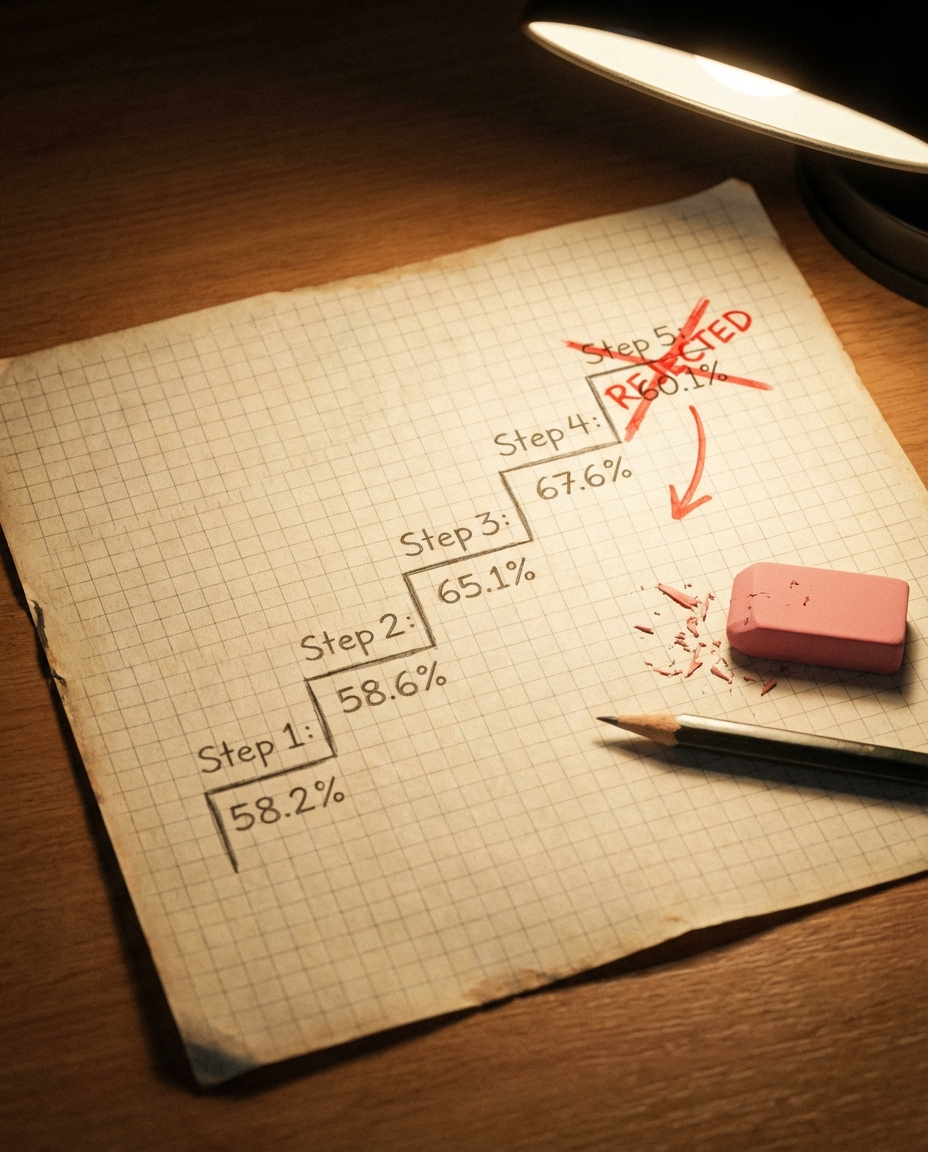
从这个干净的58.2%出发,我们用了五个阶段的实验,每个阶段只改变一个变量,严格隔离因果关系。
第一阶段:数学洗礼
把所有趋势类宏观指标从”绝对值”转换为”同比变化率”。比如,不看”CPI是3.2%”,而是看”CPI比去年同期上升了0.8个百分点”。
一个看似微小的数学变换,但它改变了系统理解数据的方式。绝对值告诉你”现在在哪”,变化率告诉你”正在往哪走”。对于判断经济周期来说,方向比位置更重要。
结果:高信心胜率微升到58.6%(+0.4个百分点)。改进很小,但方向正确。采纳。
第二阶段:利差矩阵
这是整个实验中最关键的一步。
外汇市场有一条铁律:货币的走向很大程度上由两国利率的差异决定。资金天然会从低利率的地方流向高利率的地方。我们构建了主要货币对之间的利差矩阵,让系统理解”相对宏观”而不只是”单边宏观”。
这个改动的灵感直接来自陶博士。他在2014年的文章里反复强调”大分化”:美联储在收紧,欧洲央行在放松,日本央行在加码。三大央行第一次同时朝着三个完全不同的方向走。陶博士没有孤立地分析每个央行,而是分析它们之间的差异。我们的利差矩阵,本质上就是把他的这种思维方式数量化了。
结果:高信心胜率从58.6%跳升到65.1%(+6.5个百分点)。这是五个阶段中最大的单步提升。采纳。
第三阶段:市场隐含宏观
美联储的经济数据是月度或季度发布的,天然滞后。但市场不会等数据。市场每时每刻的价格里,已经隐含了对宏观环境的实时判断。
我们加入了几个”市场隐含宏观”指标:铜金比(Copper/Gold Ratio,反映市场对经济增长的预期),信用利差(Credit Spread,反映市场的风险偏好)。
验证过程中有一个发现让团队非常兴奋:这些市场隐含信号比官方数据领先一到三个月。2020年4月COVID崩盘时,我们的隐含宏观指标打出了负111分(极度收缩),比官方经济数据的反应快了整整一个季度。
但直接叠加效果不好,因为它和利差矩阵的信号互相”抵消”了。最终方案是按品种分治:外汇品种主要看利差,大宗商品品种主要看隐含宏观。
结果:高信心胜率升到67.6%(+2.5个百分点)。采纳。
第四阶段:财政因子
这是最痛苦的一个阶段。
我们加入了美国财政部TGA账户余额和经济意外指数(Economic Surprise Index),希望捕捉财政政策对市场的影响。花了不少时间研究和调试。
结果:高信心胜率从67.6%暴跌到60.1%(-7.5个百分点)。
更糟糕的是,高信心样本数从222次膨胀到363次。这意味着财政因子把大量本该被标记为”中等信心”的信号错误地提升为”高信心”,稀释了整个高信心池的质量。
决策:果断抛弃。回退到第三阶段的版本。
这个决策的痛苦在于,我们在财政因子的研究上投入了很多时间和精力。但数据说它有害,就必须砍掉。在量化交易中,”尊重数据、拒绝沉没成本”不是口号,是生存法则。
很多量化团队死在这一步。不是技术不行,是舍不得。
第五阶段:环境细分
最后一次尝试。我们把笼统的”金发女郎经济”(Goldilocks,经济学中形容”不冷不热刚刚好”的经济环境)拆分成五个子类:纯金发女郎、晚周期、减速期、衰退前夜、早周期。
结果很有意思:总体准确率反而下降了。但在子类内部发现了极有价值的信息。比如”晚周期”环境下高信心胜率达到76.8%,”衰退前夜”达到71.8%。
最终决策:不用这个版本做预测,而是把它改造为”审核层”。上一个版本继续负责信号判断,这个版本只负责”环境体检”。当环境标签为”减速期”或”早周期”时,系统自动降低仓位或拒绝交易。
最终成绩单
五个阶段的完整演进:
重建后基线(高信心):58.2% 第一阶段 数学洗礼(+0.4):58.6% 第二阶段 利差矩阵(+6.5):65.1% 第三阶段 市场隐含宏观(+2.5):67.6% 第四阶段 财政因子(-7.5):60.1%,被抛弃,回退到67.6% 第五阶段 环境细分:作为审核层保留,不参与预测
最终锁定版本经过Walk-Forward严格验证后:
全量准确率:53.9%。高信心交易胜率:71.8%。被系统否决的信号中,44.4%事后证明确实应该被否决。
其中英镑兑美元的表现最引人注目:从修复前的29.6%(严重亏损)逆袭到77.8%。原因是利差矩阵对英镑的定价能力特别强。英国和美国之间的利率政策差异,是英镑走势最主要的驱动因素。而这个判断的根基,又可以追溯到陶博士2014年”大分化”分析中关于英国央行独立性的那些论述。
接近真实的成绩单
53.9%的全量准确率看起来不高。但在外汇日线级别的交易中,这个数字配合合理的风险收益比和仓位管理,是可以实现正期望值的。我们不追求”每次都对”,追求的是”对的时候赚得比错的时候亏得多”。
71.8%的高信心胜率是一个严格筛选后的子集。系统不是对每一个信号都出手,而是只在信心最高的时刻交易。其余时间,它选择不做。在量化交易中,”不做”往往比”做错”更有价值。
而第四阶段财政因子被果断抛弃这件事,可能是整个研发过程中最重要的决策。不是因为它省了多少钱,而是因为它证明了团队有纪律。当数据告诉你”这个方向不对”的时候,你能不能放下已经投入的时间和精力,冷静地转身?
但这还不是终点
回测通过了,胜率看起来不错。但伟博在一次讨论中泼了一盆冷水。
他指出了一个根本性的问题:我们的指纹库只有96个历史实例。在这96个样本上反复调参数,本质上是在”背答案”。就像一个学生只做了10道数学题,然后反复改答题策略让这10道题全对。看起来100分了,但换一套新卷子可能不及格。
这个问题叫做”过拟合”(Overfitting),是量化交易中仅次于未来函数的第二大杀手。
伟博的建议很直接:先不要再调参数了。现在最需要做的不是优化模型,而是扩充指纹库。从96个实例扩展到200个以上,让回测的统计基础更扎实。地基不够大的时候,上面盖的楼再漂亮也站不住。
他说的对。
于是我们暂停了模型优化,把精力重新投回到数据收集和整理上。我们扩充了数据来源,补充了更多历史年份的市场数据,最终把指纹库扩展到了超过150个实例。然后重新跑回测。
这一轮回测的结果比第一轮好得多。不是因为我们调了更多参数,而是因为样本量变大了,统计规律更稳定了。美元兑日元的准确率从最初的22%(几乎完全反向)提升到了55.6%。黄金维持在66.7%的水准。2023和2024两个新增年份的准确率分别达到61.1%和66.7%。
地基做得越大、越牢固,上层建筑才有可能做大做强。这句话听起来像老生常谈,但在量化交易中,它是用真金白银换来的教训。
下一篇讲一个更大的工程挑战:当宏观面说”看涨”但技术面说”看跌”的时候,系统听谁的?在我们的初始架构中,技术面信号以98.4%的压倒性优势碾压了宏观面。宏观信号几乎被系统性地”一票否决”了。
解决这个问题的过程中,我们做出了整个项目最重要的架构创新。
*本文是「量化交易系统研发手记」系列第5篇,共8+篇。上一篇:「一个”错误”的标注,改变了整个项目:深度学习陶博士(下)」。下一篇:「当宏观和技术面打架」*
多伦多凤凰创意网站设计开发公司原创博客,版权所有,请勿转载! 更多多伦多实战网站案例,请点击这里。
读者评价
There are no reviews yet. Be the first one to write one.