一个错误的标注,改变了整个项目:深度学习陶博士(下)
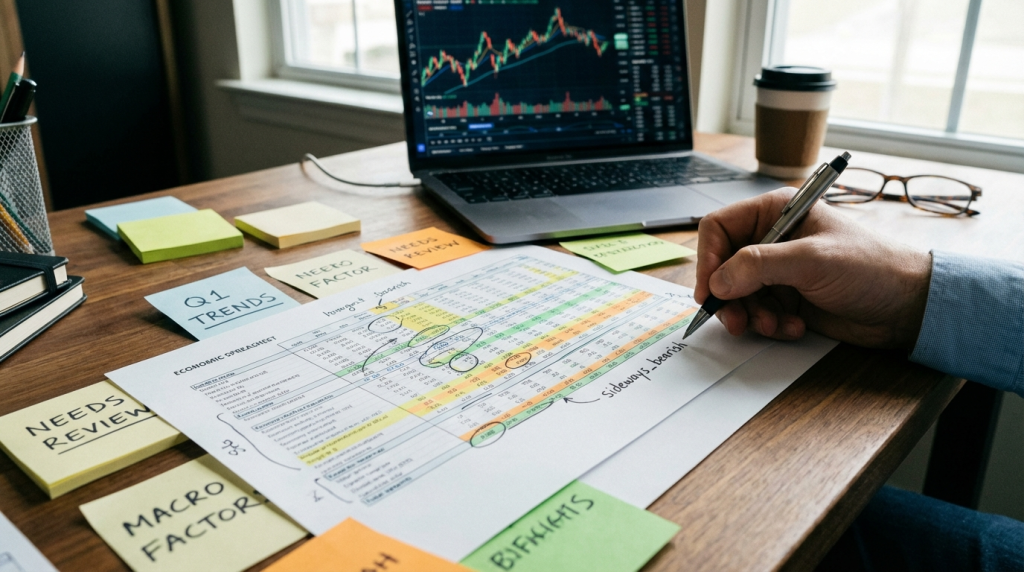
Carol 做了一件”不规范”的事。
在整理2019年和2020年的学习报告时,她需要标注每种主要货币的年度走势方向。我们给她的分类标准只有三个选项:看涨、看跌、中性。
但她没有照做。
她在2019年的报告里写了”sideways_bearish”(横盘偏弱),在2020年的报告里写了”extreme_bearish_then_recover”(极度暴跌后反弹)。这些标注完全不符合我们的规范。
伟博最先发现了这个问题。他的第一反应是”这不合规”。但他几乎同时意识到,Carol 试图表达的信息是有价值的。
“先跌后涨”和单纯的”看涨”,对于交易系统来说是完全不同的走势形态。
想一想2020年的美元。年初因为疫情恐慌,避险资金涌入,美元指数从96飙升到103。然后美联储开启无限量QE,美元掉头一路跌到年底的90。如果你把这一年标注为”看跌”,你就丢失了年初那段暴涨的信息。而那段暴涨,恰恰是最危险的时刻。
Carol 不是金融专业出身。她只是在做数据整理的时候觉得”用一个词概括一整年的走势,这不对”。但正是这种不被专业惯性束缚的视角,让她看到了一个专业人士容易忽略的盲区。
这件事后来引发了一场持续好几天的讨论,最终推动了整个项目的一次重大升级。
从三个词到分段走势
伟博提出了一个解决方案:保留原来的年度总方向(看涨、看跌、中性),同时增加一个”分段走势”字段,记录一年之内每个重大阶段的方向变化。
比如2020年的美元指数,分段走势就变成了:
一月到三月,看涨,驱动因素是COVID避险资金涌入。 四月到十二月,看跌,驱动因素是无限QE和财政刺激稀释美元。
这样一来,系统既知道2020年美元全年的净方向是下跌,也知道年内曾经有过一段猛烈的上涨。当未来出现类似的疫情冲击时,系统就能给出更细致的参考:先别急着做空美元,避险资金可能先把美元推上去,等央行开始放水之后再转向。
这个改动看起来不大,但它解决了一个根本性的问题:市场不是非黑即白的。
“你们的周期分类标准一致吗?”
Carol 的”不规范标注”被解决之后没多久,一个更大的问题浮出了水面。
我和一位做数据工程的朋友坐下来,把我们两个月研读的全部成果摊开来看。三十一个周期模式,十五份年度学习报告,每份几百行。从内容质量来看,团队做得非常扎实。
但朋友看了一会儿之后,问了一个问题:”你们的周期分类标准一致吗?”
我没有立刻理解他的意思。
他举了个例子。2014年的报告里写”美联储与ECB货币政策出现分化”,2018年的报告里写”央行政策周期错位导致汇率重估”,2022年的报告里写”全球货币政策不同步,美元独立收紧”。
“这三句话描述的是同一类现象吗?”他问。
我说,是的,本质上都是央行政策分化。
“但你的系统怎么知道它们是同一个东西?”
这个问题让我愣了好一会儿。
他说得对。我们的报告用了各种不同的词汇来描述相似的经济现象。作为读者,你能理解”政策分化”和”政策不同步”说的是同一回事。但如果未来要把这些知识接入量化系统,做跨年份的模式匹配,计算机看到的就是两个完全不同的字符串。
这意味着我们两个月的研读成果,虽然内容很好,但在结构上缺少一个关键的东西:统一的分类标准。
四层架构的诞生
那天下午的讨论持续了很久。我把我们整个项目的目标、现有成果、以及遇到的问题完整地介绍了一遍。朋友听完之后,提出了一系列补充建议,我分成四个层面逐一消化。
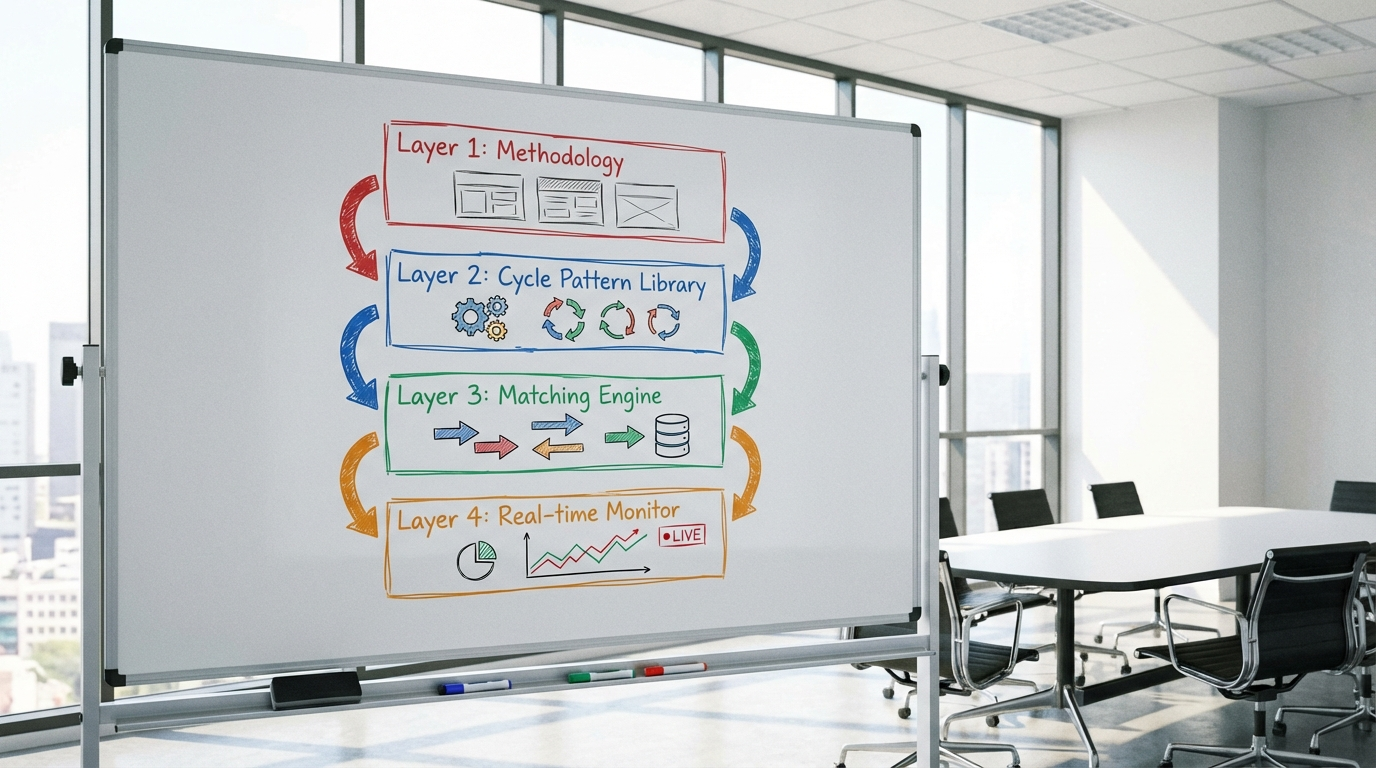
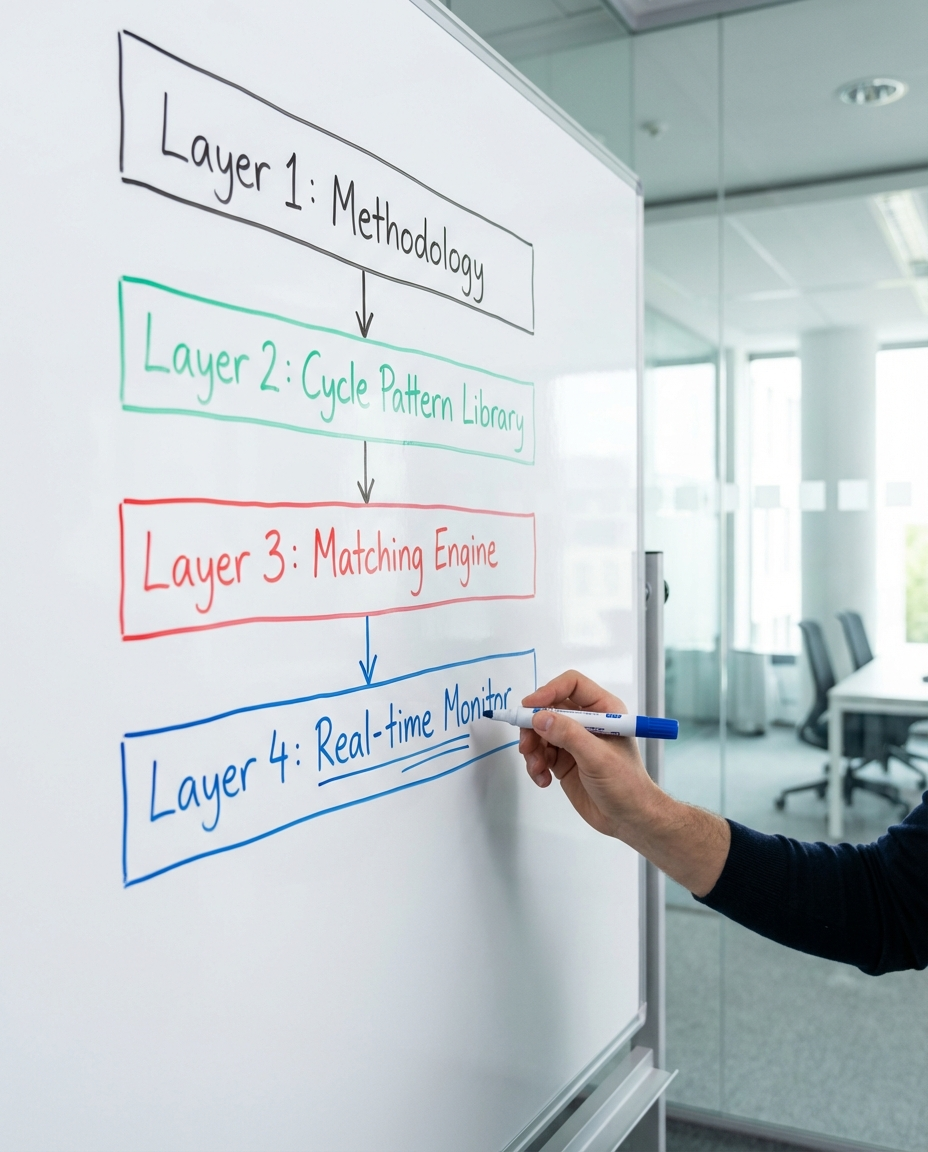
他认为我们需要的不是三层架构,而是四层。
第一层:分析方法论。 陶博士的核心分析框架。政治逻辑先行、制度信用评估、财政货币硬币模型,这些是”思维方式”,不随时间变化。这一层我们已经有了。
第二层:周期模式库。 从所有年份的学习中提炼出来的可重复识别的经济周期模式。这一层我们也有了,但需要标准化。朋友建议我们制定一份”周期分类词典”,给每个模式一个固定编号和标准化的定义,包括可量化的触发条件。这样无论谁在写报告,引用的都是同一套标准语言。
第三层:匹配引擎。 用来把当前的市场数据和历史周期模式进行相似度计算。这一层我们还没有建,但方向已经很清楚。
第四层:实时监控。 这是朋友认为我们最缺的一层。他说,前三层解决的是”我们知道什么”的问题,但没有回答”现在正在发生什么”。需要有一个机制,持续追踪当前市场的宏观指标,自动和历史模式做对比,实时告诉我们”当前最像历史上的哪个阶段”。
没有第四层,前三层就只是一个离线的研究工具。有了第四层,整个系统才能从”回顾历史”升级为”感知当下”。
我听完之后,第一个想到的就是陶博士的文章。他每周写一篇经济评论,本质上做的就是第四层的事情:观察当下正在发生什么,和历史做对比,判断我们站在周期的哪个位置。我们的四层架构,不过是试图用技术手段去复现这个过程。
标准化:最枯燥但最关键的工作
四层架构确定之后,第一件要做的事是回头补课:给所有已完成的学习报告加上标准化的标注。
这意味着Carol需要重新读一遍之前写的每一份报告,对照我们新制定的”周期分类词典”,给每个提到的经济周期标上统一的编号和触发条件。
这是整个项目里最枯燥的工作。没有新的发现,没有让人拍桌子的瞬间,只有一份一份报告地翻,一个一个标签地核实。但伟博说了一句话让大家都安静了下来:”第一层标准化是整个系统的生命线。如果这一步做不好,后面每一层都会因为数据不一致而打折扣。”
Carol花了几天时间完成了全部报告的标准化标注。伟博逐份审核,发现了一些小问题:有几份报告遗漏了触发条件的量化描述,有几个货币走势标注用了非标准的枚举值。Carol一一修复。
这个过程反复了三轮。第一轮标注,第二轮审核修复,第三轮再次全量验证。
不性感,不刺激,但绝对必要。
到最后一轮验证通过的那天,伟博在群里说了一句话:”全部报告百分之百兼容。可以直接进入下一个阶段了。”
从”读书笔记”变成了什么
回头看这两个月,我们做的事情经历了一个清晰的演变:
最开始,我们在读文章、写笔记。和任何一个坐在课堂里认真学习的学生做的事情没有区别。
然后,我们开始提炼模式。从笔记中找到重复出现的规律,给它们命名,描述它们的触发条件和演进路径。
接着,我们遇到了标准化的问题。发现不同的人用不同的语言描述同一个东西,系统无法识别。于是我们制定了统一的分类词典。
最后,我们把整套知识从”人能读懂”升级为”人和机器都能读懂”。每份报告既有给人看的文字分析,也有给系统看的结构化标签。
这个演变的起点,是Carol那个”不规范”的标注。如果她严格按照规范只写”看涨”或”看跌”,我们可能不会这么早意识到数据精度的问题。如果那位做数据工程的朋友没有问出”你们的分类标准一致吗”这个问题,我们可能要到下一个阶段才会发现标准化的缺失。
有时候,推动项目前进的不是天才的灵光一现,而是一个”不对”的感觉,或者一个看起来很简单的问题。
首次实战
标准化完成之后,伟博做了一件我们期待已久的事:他用我们整理出来的周期模式库,去分析2026年初的全球经济形势。
他收集了最新的宏观数据,逐一和三十一个历史周期模式做比对,计算相似度。
结果出来的时候,团队里安静了好一会儿。
他发现2026年初的经济环境,和历史上的多个周期片段都有不同程度的相似。有些相似跨越了十几年。某些利率结构和2008年某个阶段有相似之处,某些央行政策的犹豫模式和2019年的”预防式降息”前夕很像,某些地缘政治紧张格局又让人想起2018年贸易战刚升级的时候。
这不是一个精确的预测。伟博自己也说,匹配度只是参考,不是答案。但这是我们第一次看到,陶博士将近二十年文章中沉淀的智慧,通过系统化的整理和结构化的比对,开始帮助我们对理解当下的市场产生实际的作用。
写在三部曲的结尾
两个月,日以继夜的工作,从收集到消化到觉醒。
回头看,这段经历最让我感触的,不是我们学到了多少经济学知识,而是我们学会了一种看待世界的方式。
陶博士的文章教给我们的核心,可以用一句话概括:不预测终点,只判断位置。
不去猜明天市场涨还是跌。而是搞清楚我们现在站在经济周期的哪个阶段,历史上类似的阶段后来发生了什么,然后根据这个判断做出相应的准备。
这个理念贯穿了陶博士将近二十年的写作。也贯穿了我们整个量化交易系统的设计哲学。
如果说陶博士的文章是一片森林,那我们这两个月做的事情,就是在森林里一棵一棵树地走过去,记录每一棵树的位置、高度、品种,然后站到森林外面,试着画出一张地图。
这张地图不完美。因为时间和资源的限制,我们只有两个月来研读和提炼内容,非常期待未来能有更多时间和资源,继续研读陶博士文章里面的精髓。
而走这条路的起点,是一位经济学家将近二十年的无私分享。对此,我们心怀深深的感激。
下一篇,我们开始讲技术。讲我们怎么把这张知识地图和真实的市场数据连接起来,以及在这个过程中遇到的第一个重大陷阱:未来函数。
如果你做过量化回测,看到”未来函数”三个字可能已经脊背发凉了。
如果你没做过,下一篇会让你理解,为什么这三个字是每一个量化团队最害怕的噩梦。
*本文是「量化交易系统研发手记」系列第4篇,共8+篇。上一篇:「从金融海啸到激进加息,我们读到停不下来:深度学习陶博士(中)」。下一篇:「未来函数:我们差点被自己的回测骗了」*
多伦多凤凰创意网站设计开发公司原创博客,版权所有,请勿转载! 更多多伦多实战网站案例,请点击这里。
读者评价
There are no reviews yet. Be the first one to write one.